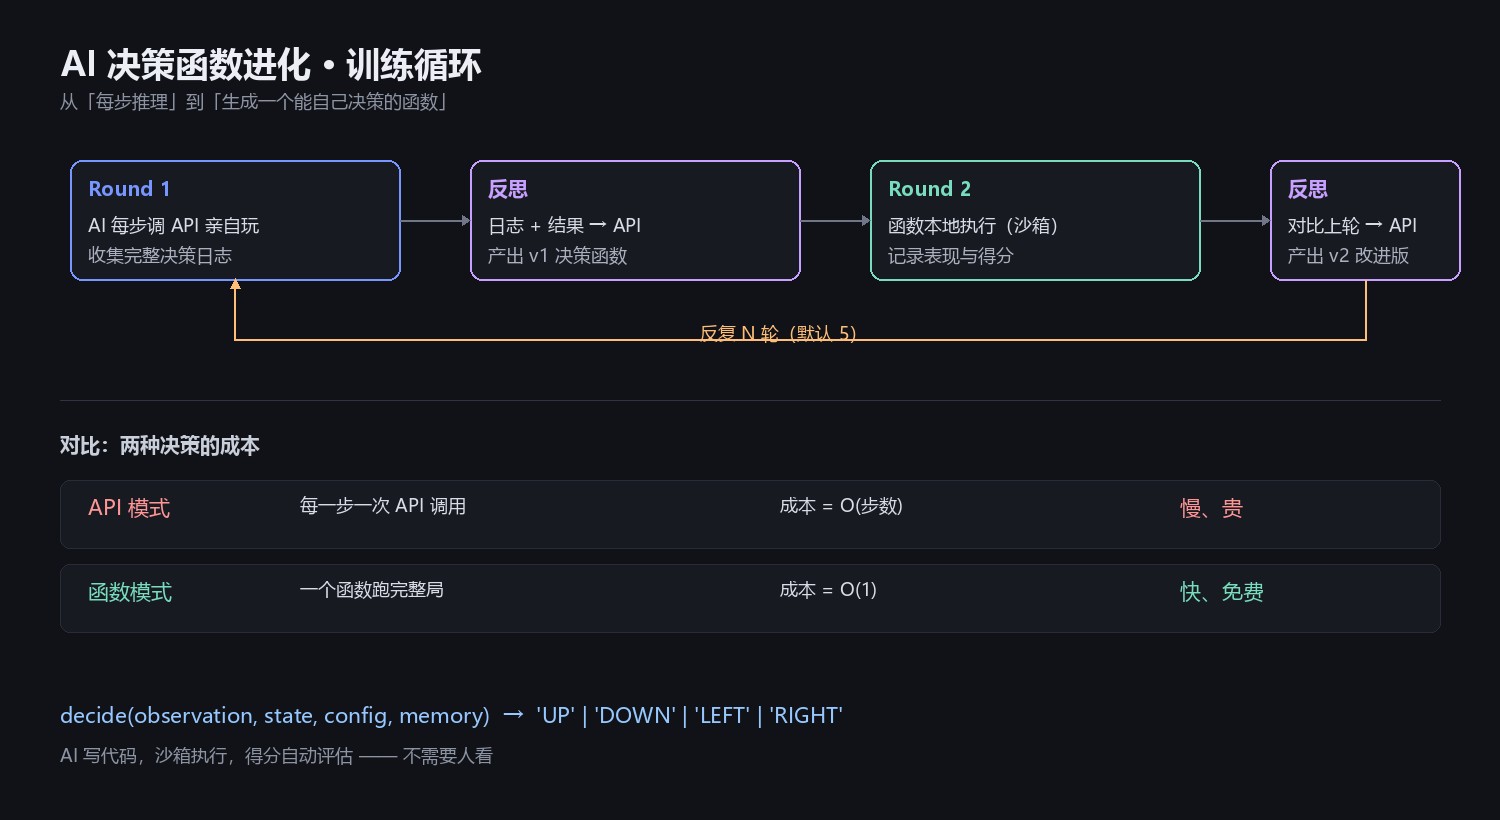
表面上看,这是个网页小游戏。
一个机器人在地图上走,收集正分地块,躲开负分地块,在限定步数内拿最高分。
但真正被测试的不是机器人。
是 AI 会不会给自己写一个能赢的函数。
第一轮:AI 亲自玩
Round 1,机器人每一步都由 API 驱动:
| |
每步的响应是两行:
| |
「思考」显示在日志面板里,「行动」驱动移动。
这一轮很慢,也很贵——每一步都是一次 API 调用。一局 60 步,就是 60 次请求。
但它产出了一样极有价值的东西:一份完整的决策日志。
反思:把日志变成代码
一局结束后,我把整局记录发回给 AI:
- 每一步它看到了什么
- 每一步它决定了什么
- 最终的得分与路径
然后要求它:不要再一步一步决定。写一个函数,让函数来替你做决定。
产出长这样:
| |
这就是 v1。
关键转折:成本从 O(步数) 变成 O(1)

对比一下两种驱动方式:
| API 模式 | 函数模式 | |
|---|---|---|
| 驱动 | 每步一次 API 调用 | 本地执行一个函数 |
| 成本 | O(步数) | O(1) |
| 速度 | 每秒 1~2 步(受网络限制) | 每秒上万步 |
| 可复现 | 依赖模型版本 | 完全确定 |
同一个 AI,在第二轮里变成了一个 100 行的函数。
然后这个函数可以跑几千局——不需要再花任何 API 费用。
进化:让函数一代代变强
第二轮结束后,把「函数表现」和「上一轮表现」一起发回给 AI,让它改进。
| |
默认 5 轮。每一轮的函数版本都存进 localStorage,可以:
- 查看任意版本的代码
- 手动编辑再测
- 导出/导入
- 对比各代得分
一个反直觉的地方
函数变得更长,不一定变得更强。
我观察到的情况是:前两代函数通常一路膨胀(加启发式、加规则、加特判),但从第三代开始往往会缩短——AI 会主动删掉那些在实测里没帮助的分支。
这其实很像人类写代码的过程:先什么都想加,再靠数据砍掉。
沙箱:AI 写的代码不能直接信任
decide 是 AI 生成的任意 JavaScript。
直接 eval 等于把浏览器交出去。
所以:
- 代码在 Web Worker 里执行,拿不到 DOM 和网络
- 执行前做语法校验(
new Function能构造出来才算合法) - 必须有名为
decide的函数,否则拒绝装载 - 抛异常就捕获、记录、不回退到默认策略(否则你永远不知道它坏了)
| |
一个 AI 写的函数,要么在受限环境里跑,要么别跑。
顺带测的第二件事:长上下文记忆
这个游戏还测了另一条线——AI 在不同信息密度下的决策质量。
历史信息可以切换成两种模式:
| 模式 | 每步传给 API 的内容 | 上下文大小 |
|---|---|---|
| 完整历史 | 每步观察 + 决策 + 完整路径 | 线性增长 |
| 压缩摘要 | 已收集分数列表 + 已访问坐标集合 | 基本恒定 |
这就是一个很干净的对照实验:
同一个模型,给它线性增长的上下文,和给它固定大小的摘要,决策质量会不会下降?
而且这个问题在当前特别实际——所有做长上下文应用的人都要面对。
网格本身也是变量
为了不让实验退化成「一张随机图上的运气」,网格可以精细配置:
分数分布
- 均匀分布 / 正态分布(可调均值、标准差)
- 正分格占比(默认 60%)
- 数值取整,正态钳制到
[min, max]
墙壁结构
corridor— 曲折走廊,终点高奖励room— 封闭房间,1~2 个入口,内部高奖励maze— 递归分割小迷宫,死胡同里藏高奖励- 随机递归分割(可设递归深度)
- 结构深处的格子奖励 2x~3x
同一份决策函数,在开放地图上可能很聪明,在迷宫里可能直接走进死胡同。
所以只测一种地图是不够的。
一个必须处理的边界情况
设计文档里我列了一张边缘情况表,其中一条特别重要:
| 场景 | 行为 |
|---|---|
| 函数代码执行异常 | 捕获错误,日志提示,不回退 |
为什么不回退到「随机走」?
因为静默降级会让统计数据失真。如果函数坏了却自动换成随机策略,你会看到「这一代得分下降了」,但不知道为什么——你会以为是策略变差了,实际上是崩溃了。
让失败暴露出来,比让它看起来能跑更重要。
这个项目真正在问什么
表面上它在问:AI 能不能在网格游戏里拿高分?
实际上它在问三个问题:
- AI 能不能从「做决策」上升到「写决策程序」?
- 写出来的程序,能不能在一代代反馈中变好?
- 上下文从线性增长换成固定摘要,它的判断会退步多少?
第一个是能力边界,第二个是进化机制,第三个是工程现实。
而这三件事,恰好也是今天做 AI 应用的人每天在纠结的。
技术栈
原生 JavaScript · Canvas · DeepSeek API · Web Worker 沙箱 · localStorage · 零构建步骤
这个项目让我改了一个看法。
以前我觉得「AI 会不会写代码」是个演示性问题。
现在我觉得它是成本问题——当 AI 学会写一个函数来代替自己反复推理时,它就从「一次服务」变成了「一份资产」。